Elo-Rating und Tennis-Wettmodelle – Datenbasiert tippen
 Available in US
Ladevorgang...
Inhaltsverzeichnis
Ein Elo-Rating macht aus Meinungen Zahlen — und aus Zahlen Wahrscheinlichkeiten.
Wer die Formkurve eines Spielers analysiert, arbeitet mit qualitativen Einschätzungen, die von Erfahrung und Interpretation abhängen. Das Elo-Rating geht einen Schritt weiter: Es quantifiziert die Spielstärke in einer einzigen Zahl, die sich nach jedem Match automatisch anpasst — und aus der sich direkt Gewinnwahrscheinlichkeiten ableiten lassen. Für Wetter, die ihre Entscheidungen auf ein systematisches Fundament stellen wollen, ist das Elo-System der natürliche Ausgangspunkt, um vom Bauchgefühl zum datenbasierten Modell zu gelangen. Kein anderer Ansatz bietet ein so klares Verhältnis von Aufwand zu Vorhersagekraft.
Elo-Rating erklärt: Ursprung und Mechanik
Das Elo-System wurde in den 1960er-Jahren vom ungarisch-amerikanischen Physiker Arpad Elo für die Bewertung von Schachspielern entwickelt. Die US Chess Federation übernahm das System 1960, die FIDE folgte 1970. Die Grundidee ist elegant in ihrer Einfachheit: Jeder Spieler erhält eine numerische Bewertung — typischerweise startend bei 1500 —, die nach jedem Duell angepasst wird, abhängig davon, ob das Ergebnis erwartet oder überraschend war. Neue Spieler beginnen am gleichen Ausgangspunkt; ihre wahre Spielstärke kristallisiert sich nach zwanzig bis dreißig gewerteten Matches heraus.
Gewinnt ein hoch bewerteter Spieler gegen einen niedrig bewerteten, ändert sich wenig — das Ergebnis war vorhersehbar. Gewinnt aber der Schwächere, verschiebt sich deutlich: Der Sieger steigt stark, der Verlierer fällt stark. Die Stärke der Anpassung wird durch den K-Faktor gesteuert, einen Parameter, der bestimmt, wie reaktiv das System auf neue Ergebnisse reagiert. Ein hoher K-Faktor macht das Rating volatiler und empfindlicher für aktuelle Form; ein niedriger K-Faktor glättet die Kurve und gewichtet die langfristige Leistung stärker. Im Tennis hat sich ein K-Faktor zwischen 20 und 32 als praktikabel erwiesen — hoch genug, um Formveränderungen abzubilden, aber niedrig genug, um einzelne Ausreißer nicht überzubewerten.
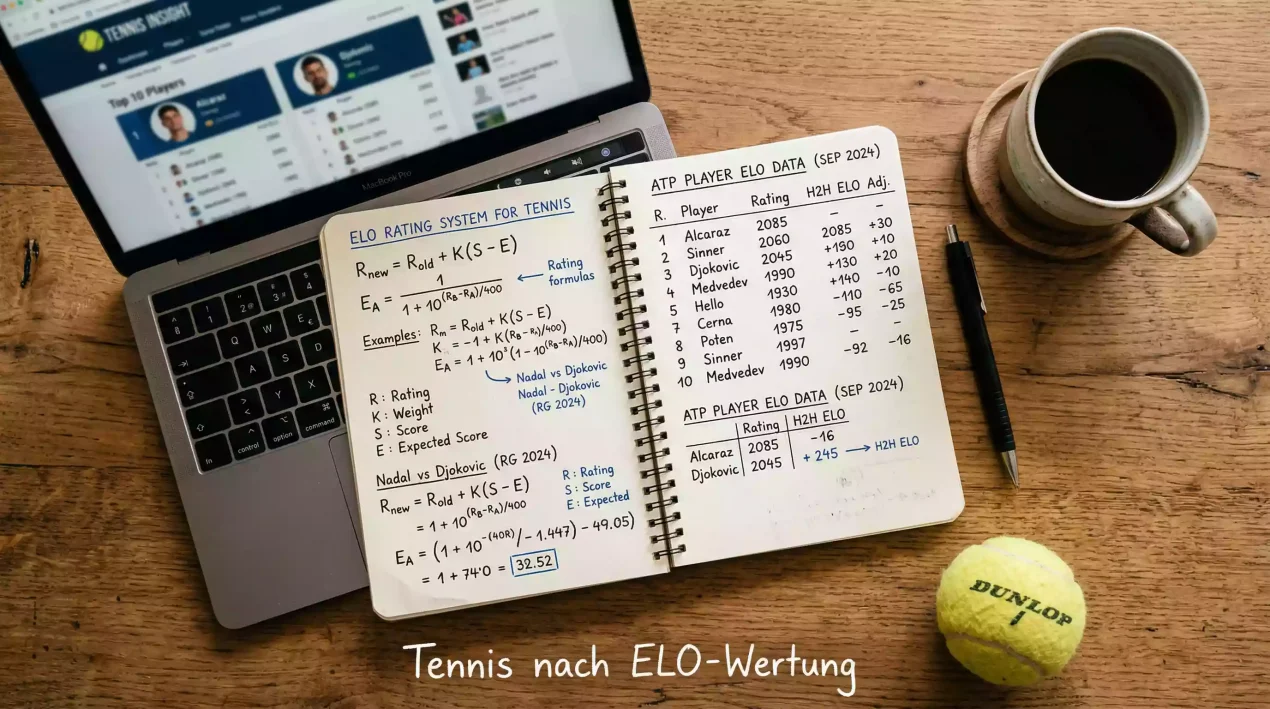
Ein Berechnungsbeispiel: Spieler A hat ein Elo-Rating von 1800, Spieler B von 1650. Die erwartete Gewinnwahrscheinlichkeit für A berechnet sich als 1 / (1 + 10^((1650-1800)/400)) = circa 70 Prozent. Gewinnt A tatsächlich, steigt sein Rating um wenige Punkte. Gewinnt B — der Upset —, verschiebt sich das Rating stärker, weil das Ergebnis von der Prognose abweicht. Nach tausenden von Matches bildet das Elo-Rating eine erstaunlich präzise Rangordnung der Spielstärke ab.
Elo vs. ATP-/WTA-Ranking: Wo liegen die Unterschiede?
Das ATP-Ranking belohnt Turnierergebnisse. Das Elo-Rating belohnt Siege gegen starke Gegner. Dieser Unterschied hat massive Konsequenzen für die Vorhersagequalität — und damit für den Wert beider Systeme als Grundlage für Wettentscheidungen.
Im offiziellen Ranking-System bekommt ein Spieler die gleiche Punktzahl für einen Finalsieg, unabhängig davon, ob er im Finale die Nummer eins der Welt oder die Nummer 40 geschlagen hat. Ein Spieler, der bei drei ATP-250-Turnieren das Finale erreicht, sammelt die gleiche Punktzahl wie einer, der bei einem Masters-Turnier das Viertelfinale erreicht — obwohl die Qualität der besiegten Gegner im zweiten Fall typischerweise deutlich höher liegt. Das Elo-System gewichtet dagegen die Stärke des Gegners direkt: Ein Sieg gegen einen Top-5-Spieler bringt deutlich mehr Rating-Punkte als ein Sieg gegen einen Qualifikanten. Das macht das Elo-Rating prädiktiver — mehrere akademische Studien haben gezeigt, dass Elo-basierte Vorhersagen die Vorhersagequalität des offiziellen Rankings bei Tennismatches übertreffen, typischerweise um zwei bis fünf Prozentpunkte bei der Trefferquote.
Das klingt nach wenig. Aber auf hunderte Wetten hochgerechnet ist es der Unterschied zwischen einer negativen und einer positiven Langzeitbilanz — und damit genau die Art von Edge, die systematische Wetter suchen.
Ein weiterer Unterschied: Das Ranking verfällt in festen Zyklen, das Elo-Rating entwickelt sich kontinuierlich. Es gibt keine künstlichen Punkte-Klippen im Elo-System — die Spielstärke wird fließend abgebildet, was für die Quotenbewertung deutlich nützlicher ist als ein System, das alle zwölf Monate abrupt Punkte abzieht.
Belaganpassung: Surface-Elo
Ein allgemeines Elo-Rating für Tennis hat eine grundsätzliche Schwäche: Es behandelt Sand, Rasen und Hartplatz gleich. Das ist ein Problem, weil die Beläge den Sport fundamental verändern — und damit die Spielstärke eines Athleten auf verschiedenen Untergründen dramatisch variieren kann.
Die Lösung heißt Surface-Elo — getrennte Elo-Bewertungen für jeden Belag. Dienste wie Tennis Abstract veröffentlichen solche belagspezifischen Elo-Ratings. Ein Spieler mit einem Gesamt-Elo von 1750 könnte auf Sand ein Surface-Elo von 1850 haben, auf Rasen aber nur 1620. Die Differenz von 230 Punkten entspricht einem völlig anderen Erwartungsprofil: Auf Sand wäre dieser Spieler ein klarer Favorit gegen die meisten Gegner in seinem allgemeinen Elo-Bereich; auf Rasen wäre er der Außenseiter. Wer nur das Gesamt-Elo verwendet, übersieht diese Differenz und trifft suboptimale Wettentscheidungen.
Surface-Elo ist deshalb kein optionaler Zusatz, sondern eine notwendige Verfeinerung für jedes ernsthafte Tennis-Wettmodell. Die Herausforderung liegt in der Stichprobengröße: Auf Rasen spielen die meisten Spieler nur wenige Turniere pro Jahr, was die Elo-Werte auf diesem Belag volatiler macht als auf Hartplatz, wo die Datenbasis am größten ist. Ein pragmatischer Ansatz: Auf Rasen das Surface-Elo stärker mit dem Gesamt-Elo mischen, um die geringe Stichprobe auszugleichen.
Ein einfaches Tennis-Wettmodell aufbauen
Der Schritt vom Elo-Rating zum funktionierenden Wettmodell erfordert keine Programmierkenntnisse auf Expertenniveau — eine Tabellenkalkulation reicht für den Anfang aus. Entscheidend ist ein systematisches Vorgehen, das drei Phasen umfasst: Variablen definieren, Wahrscheinlichkeiten berechnen und das Modell gegen reale Quoten testen. Jede Phase baut auf der vorherigen auf, und der Versuch, Schritte zu überspringen, führt zu einem Modell, das auf dem Papier funktioniert, aber in der Praxis versagt.
Variablen definieren
Das Grundmodell arbeitet mit drei Eingabevariablen: dem Surface-Elo beider Spieler auf dem aktuellen Belag, einem Formfaktor, der die Ergebnisse der letzten zehn Matches gewichtet, und optional einem Heimvorteil-Korrekturfaktor, der bei Davis-Cup-Matches oder Turnieren im Heimatland relevant sein kann. Der Surface-Elo liefert die Basiswahrscheinlichkeit, der Formfaktor korrigiert sie nach oben oder unten, je nachdem, ob ein Spieler aktuell über oder unter seinem erwarteten Niveau spielt. Fortgeschrittene Modelle ergänzen weitere Variablen — Aufschlagstatistiken, Ermüdungsfaktoren aus dem Turnierkalender, Best-of-3 versus Best-of-5-Anpassung —, aber das Grundmodell mit drei Variablen liefert bereits einen soliden Ausgangspunkt, der besser ist als reines Bauchgefühl.
Gewinnwahrscheinlichkeit berechnen
Die Expected-Score-Formel aus dem Elo-System liefert direkt eine Gewinnwahrscheinlichkeit: P(A) = 1 / (1 + 10^((Elo_B – Elo_A)/400)). Bei einem Elo-Unterschied von 150 Punkten ergibt sich eine Gewinnwahrscheinlichkeit von rund 70 Prozent für den höher bewerteten Spieler. Bei 300 Punkten Differenz steigt sie auf über 85 Prozent. Diese Rohwahrscheinlichkeit wird durch den Formfaktor angepasst — ein Spieler, der in den letzten zehn Matches sieben gewonnen hat und dabei einen Expected Win von nur fünf hatte, liegt in seiner Form über der Elo-Erwartung, und das Modell addiert einen kleinen Bonus zur Gewinnwahrscheinlichkeit.
Die Kalibrierung dieses Bonus ist der sensibelste Schritt im gesamten Modellbau. Zu viel Gewicht auf die aktuelle Form macht das Modell anfällig für Zufallsserien — ein Spieler, der fünf Matches gegen schwache Gegner gewonnen hat, ist nicht automatisch in Topform. Zu wenig Gewicht auf die Form ignoriert reale Leistungsveränderungen. Ein praktischer Ansatz: Den Formfaktor auf maximal plus/minus fünf Prozentpunkte begrenzen, damit er die Basiswahrscheinlichkeit justiert, aber nicht dominiert.
Modell gegen Quoten testen
Ein Modell, das nicht gegen historische Daten getestet wird, ist wertlos — egal wie elegant seine Mathematik aussieht. Der Backtest vergleicht die modellbasierten Wahrscheinlichkeiten mit den tatsächlichen Ergebnissen vergangener Matches und misst, ob das Modell kalibriert ist — also ob Matches, denen das Modell eine 70-prozentige Gewinnwahrscheinlichkeit zuweist, auch tatsächlich in rund 70 Prozent der Fälle vom prognostizierten Spieler gewonnen werden. Eine schlechte Kalibrierung bedeutet, dass das Modell systematisch zu selbstsicher oder zu vorsichtig ist — beides kostet langfristig Geld.
Der eigentliche Wetttest geht weiter: Das Modell identifiziert alle Matches, bei denen die eigene Wahrscheinlichkeit höher liegt als die Implied Probability der Buchmacherquote, und simuliert, was passiert wäre, wenn man konsequent auf diese Value-Bets gesetzt hätte. Die Kennzahl ist der ROI — Return on Investment. Ein positiver ROI über mindestens 500 Testwetten deutet darauf hin, dass das Modell eine echte Edge hat. Alles unter 500 Wetten ist zu wenig Stichprobe, um Zufall von Können zu trennen. Typische Fallstricke: Overfitting — das Modell funktioniert perfekt auf historischen Daten, aber versagt bei neuen Matches, weil es Muster gelernt hat, die nicht verallgemeinerbar sind.
Modell schlägt Meinung – auf Dauer
Ein Modell ist kein Allheilmittel. Es wird einzelne Matches falsch einschätzen, Upsets nicht vorhersehen und in Phasen hoher Varianz frustrierend wirken. Es kann keine Verletzungen vorhersagen, keine Motivationsschwankungen erfassen und keine Wetterbedingungen einpreisen.
Aber es schützt vor dem gefährlichsten Gegner jedes Wetters: dem eigenen Bias. Ein Modell setzt nicht aus Sympathie, ignoriert keine unbequemen Statistiken und erhöht nicht den Einsatz nach einer Verlustserie. Es liefert eine nüchterne Einschätzung, gegen die der Wetter seine eigene Meinung prüfen kann — und genau diese Kontrollinstanz ist auf Dauer wertvoller als jeder einzelne heiße Tipp. Wer den Aufwand investiert, ein einfaches Elo-basiertes Modell aufzubauen und zu pflegen, hat einen systematischen Vorteil, der sich über hunderte von Wetten auszahlt — nicht weil das Modell immer recht hat, sondern weil es konsistent und emotionslos arbeitet.
